项目作品 · 本地推理
LittleModel Lab
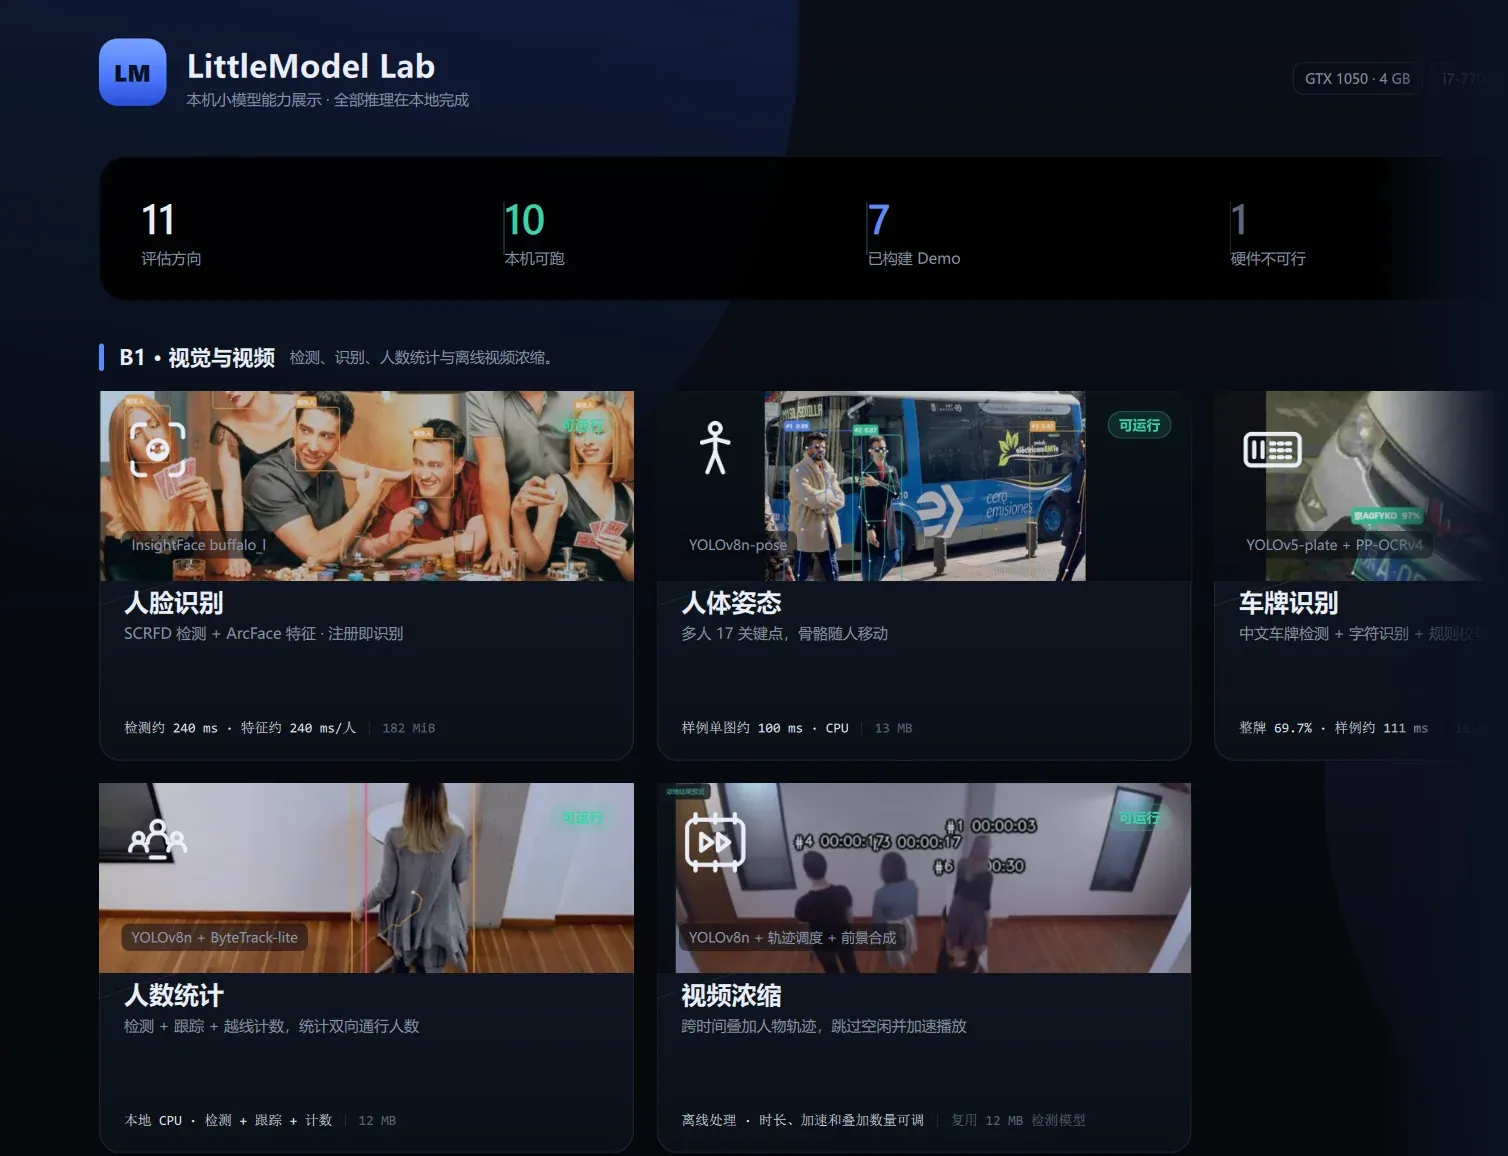
把开源专项小模型做成一台普通笔记本就能跑起来的桌面 Demo 集。八个功能一个入口,全部在本机推理,不上传图片、不调云端接口。
- 状态
- 可运行,未发布
- 平台
- Windows x64
- 技术
- Qt 6.8 + ONNX Runtime + llama.cpp
- 开发机
- i7-7700HQ / GTX 1050 4GB
要解决的问题
小模型的能力边界很模糊:「能跑」和「能用」之间差着参数、预处理和失败案例。这个项目的重点不是把模型接进来就完事,而是给每个 Demo 标清楚——最佳用法是什么、什么时候会失败、在本机实测多快。看不清边界的能力,用起来就是赌运气。
现在能跑的八个
-
人脸识别
InsightFace SCRFD 检测加 ArcFace 特征,支持 1:N 比对与注册。
-
人体姿态
YOLOv8n-pose,多人 17 关键点,实时叠加骨架。
-
车牌识别
YOLOv5-plate 检测配 PP-OCRv4 识别,中文车牌整牌输出。
-
人数统计
YOLOv8n 检测加轻量 ByteTrack 跟踪,按越线方向计数。
-
视频浓缩
把不同时段的轨迹排到同一条时间轴,压缩空闲时间,导出 MJPEG AVI。
-
单目点云
Depth Anything V2 出深度,转成可旋转缩放的点云并导出 PLY。
-
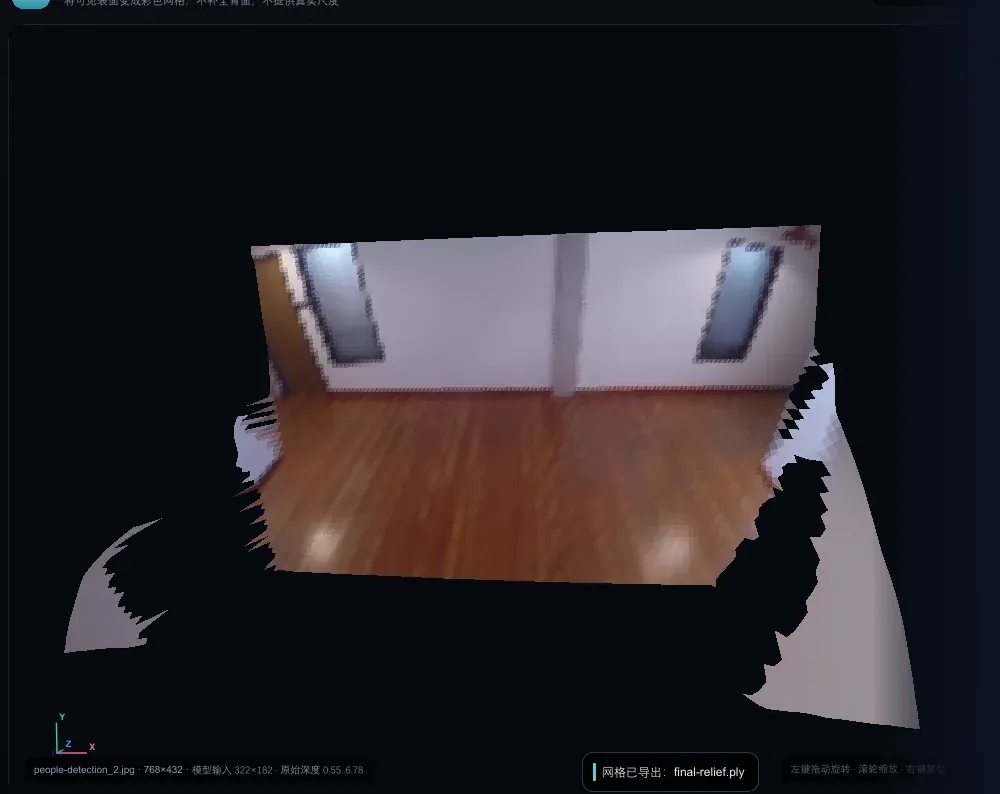
单图浮雕
同一套深度模型生成带顶点色的三角网格,支持转台与 PLY 导出。
-
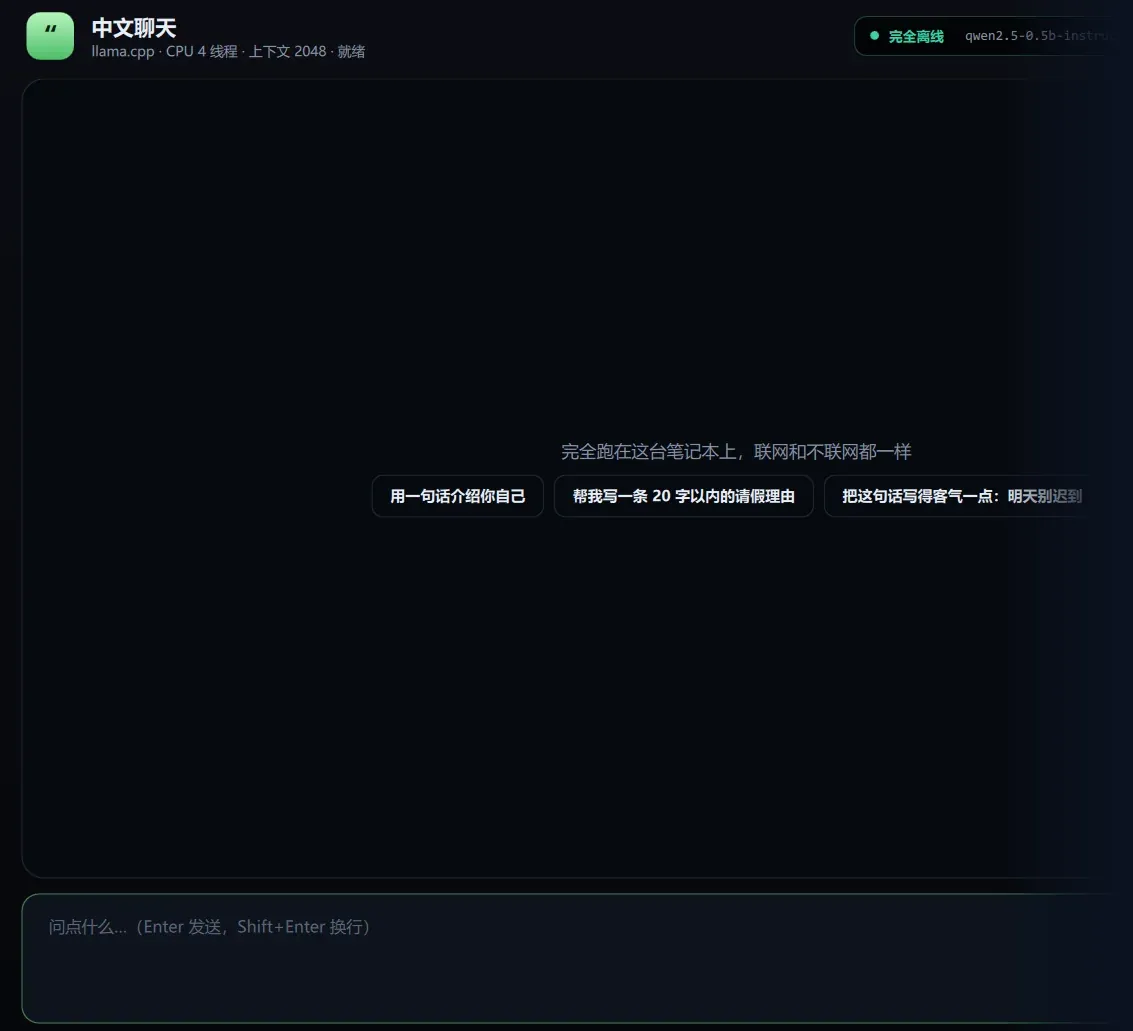
中文聊天
Qwen2.5-0.5B-Instruct 量化版经 llama.cpp 流式输出,可停止、可多轮。
每张卡片都写清边界
卡片右下角和每个 Demo 顶栏都能打开同一份说明面板,四块内容固定:最佳用法、能力边界、实测指标(含数据集、样本量和硬件条件)、已知失败案例。文案只维护一份 assets/demos.json,界面和文档读同一个源,避免宣传口径和实际表现对不上。
- 不吹精度。车牌在 119 张自建样例上整牌正确率 90.76%,是同一批小样本的结果,不当作独立测试集精度。
- 不吹 GPU。当前全部走 CPU 推理,4 GB 显存只是开发机配置,不表示已启用显卡加速。
- 不吹 3D。点云是带近似相机参数的相对深度可视化;浮雕只有可见表面,没有背面和真实尺寸,不能直接打印。
- 许可写明白。代码 MIT,但 InsightFace 权重等仅限非商用研究,商用前必须替换或取得授权。
工程细节
每个 Demo 是独立进程,入口会先检查可执行文件和模型权重是否存在且非空,缺模型就不显示「可运行」,而不是点进去再报错。推理线程数可以统一限制,方便在后台还有别的模型在跑时让出 CPU。交付是免安装的 run/ 目录,约 174 MB,含八个可执行文件和全部运行库,双击即可进入汇总页。
界面